B站视频与网页剪藏自动转逐字稿和带时间戳可跳转的AI摘要
把 B 站视频与网页剪藏自动转成带时间戳的逐字稿和 AI 摘要:字幕优先、ASR 兜底,摘要锚点由脚本机械校验,杜绝 AI 编造
vault-ingestor agent 是一个「BiliBili视频 / 网页文档剪藏」工作流:将通过 Obsidian Web Clipper (谷歌浏览器插件)剪藏的 B 站视频与网页文档,批量转成「带时间戳逐字稿 + 基于逐字稿的 AI 摘要」,并写入用户自定义文件夹_Capture/_Clipper/目录下。vault-ingestor 使用确定性脚本对视频抓取转录、agent 只负责根据模板编写AI摘要、脚本再机械校验锚点来保证 AI 摘要内容基于逐字稿不编造
一、功能与效果
解决的问题
- 剪藏只进不出:B 站看到好视频、网页读到好文章,用 Web Clipper 剪藏之后就再没打开——视频舍不得花时间看、文章堆着不消化,剪藏文件夹慢慢变成信息垃圾场;
- 视频转写流程复杂、耗时:逐字稿只能手动听打或借助第三方转写工具,一次只能处理一个视频、无法批量,转写速度慢、结果还容易出错;从逐字稿到 AI 总结又要人工搬运,缺少一条端到端的工作流;
- AI 总结不可信:AI 总结容易编造原文里没有的结论,需要回原文逐条核对。
处理逻辑
- 在 opencode 里输入
/vault-ingest(command),由vault-ingestoragent 编排三段流程:①ingest.py --prepare扫描_Capture/*.md(网页剪藏储存根目录)、分类并判重,视频优先直抓 B 站现成字幕、无字幕才下载音频走云 ASR 兜底,文章直接复用剪藏正文;② 随后 agent 逐条读逐字稿写AI摘要;③ 最后ingest.py --finalize机械校验每个锚点确实存在于逐字稿中,通过才标summarized,否则标needs-review。
产出形态 & 适用范围
- 每篇剪藏产出「完整逐字稿(落在
_Capture/_Clipper/transcripts/)+ 同名AI摘要笔记(落在_Capture/_Clipper/)」,摘要笔记正文完全按剪藏笔记格式规范(_Capture/_Clipper/_剪藏模板.md,随资源包分发)组织,视频要点以[MM:SS](视频URL?t=秒#t=MM:SS.ff)开头,配合media-extended插件点击即跳回视频对应位置,「文章要点」则以原文引句锚定。 - 适用于个人知识库的碎片剪藏定期消化、视频课与播客转文字归档——即「收藏夹」要变成「可检索的知识」。
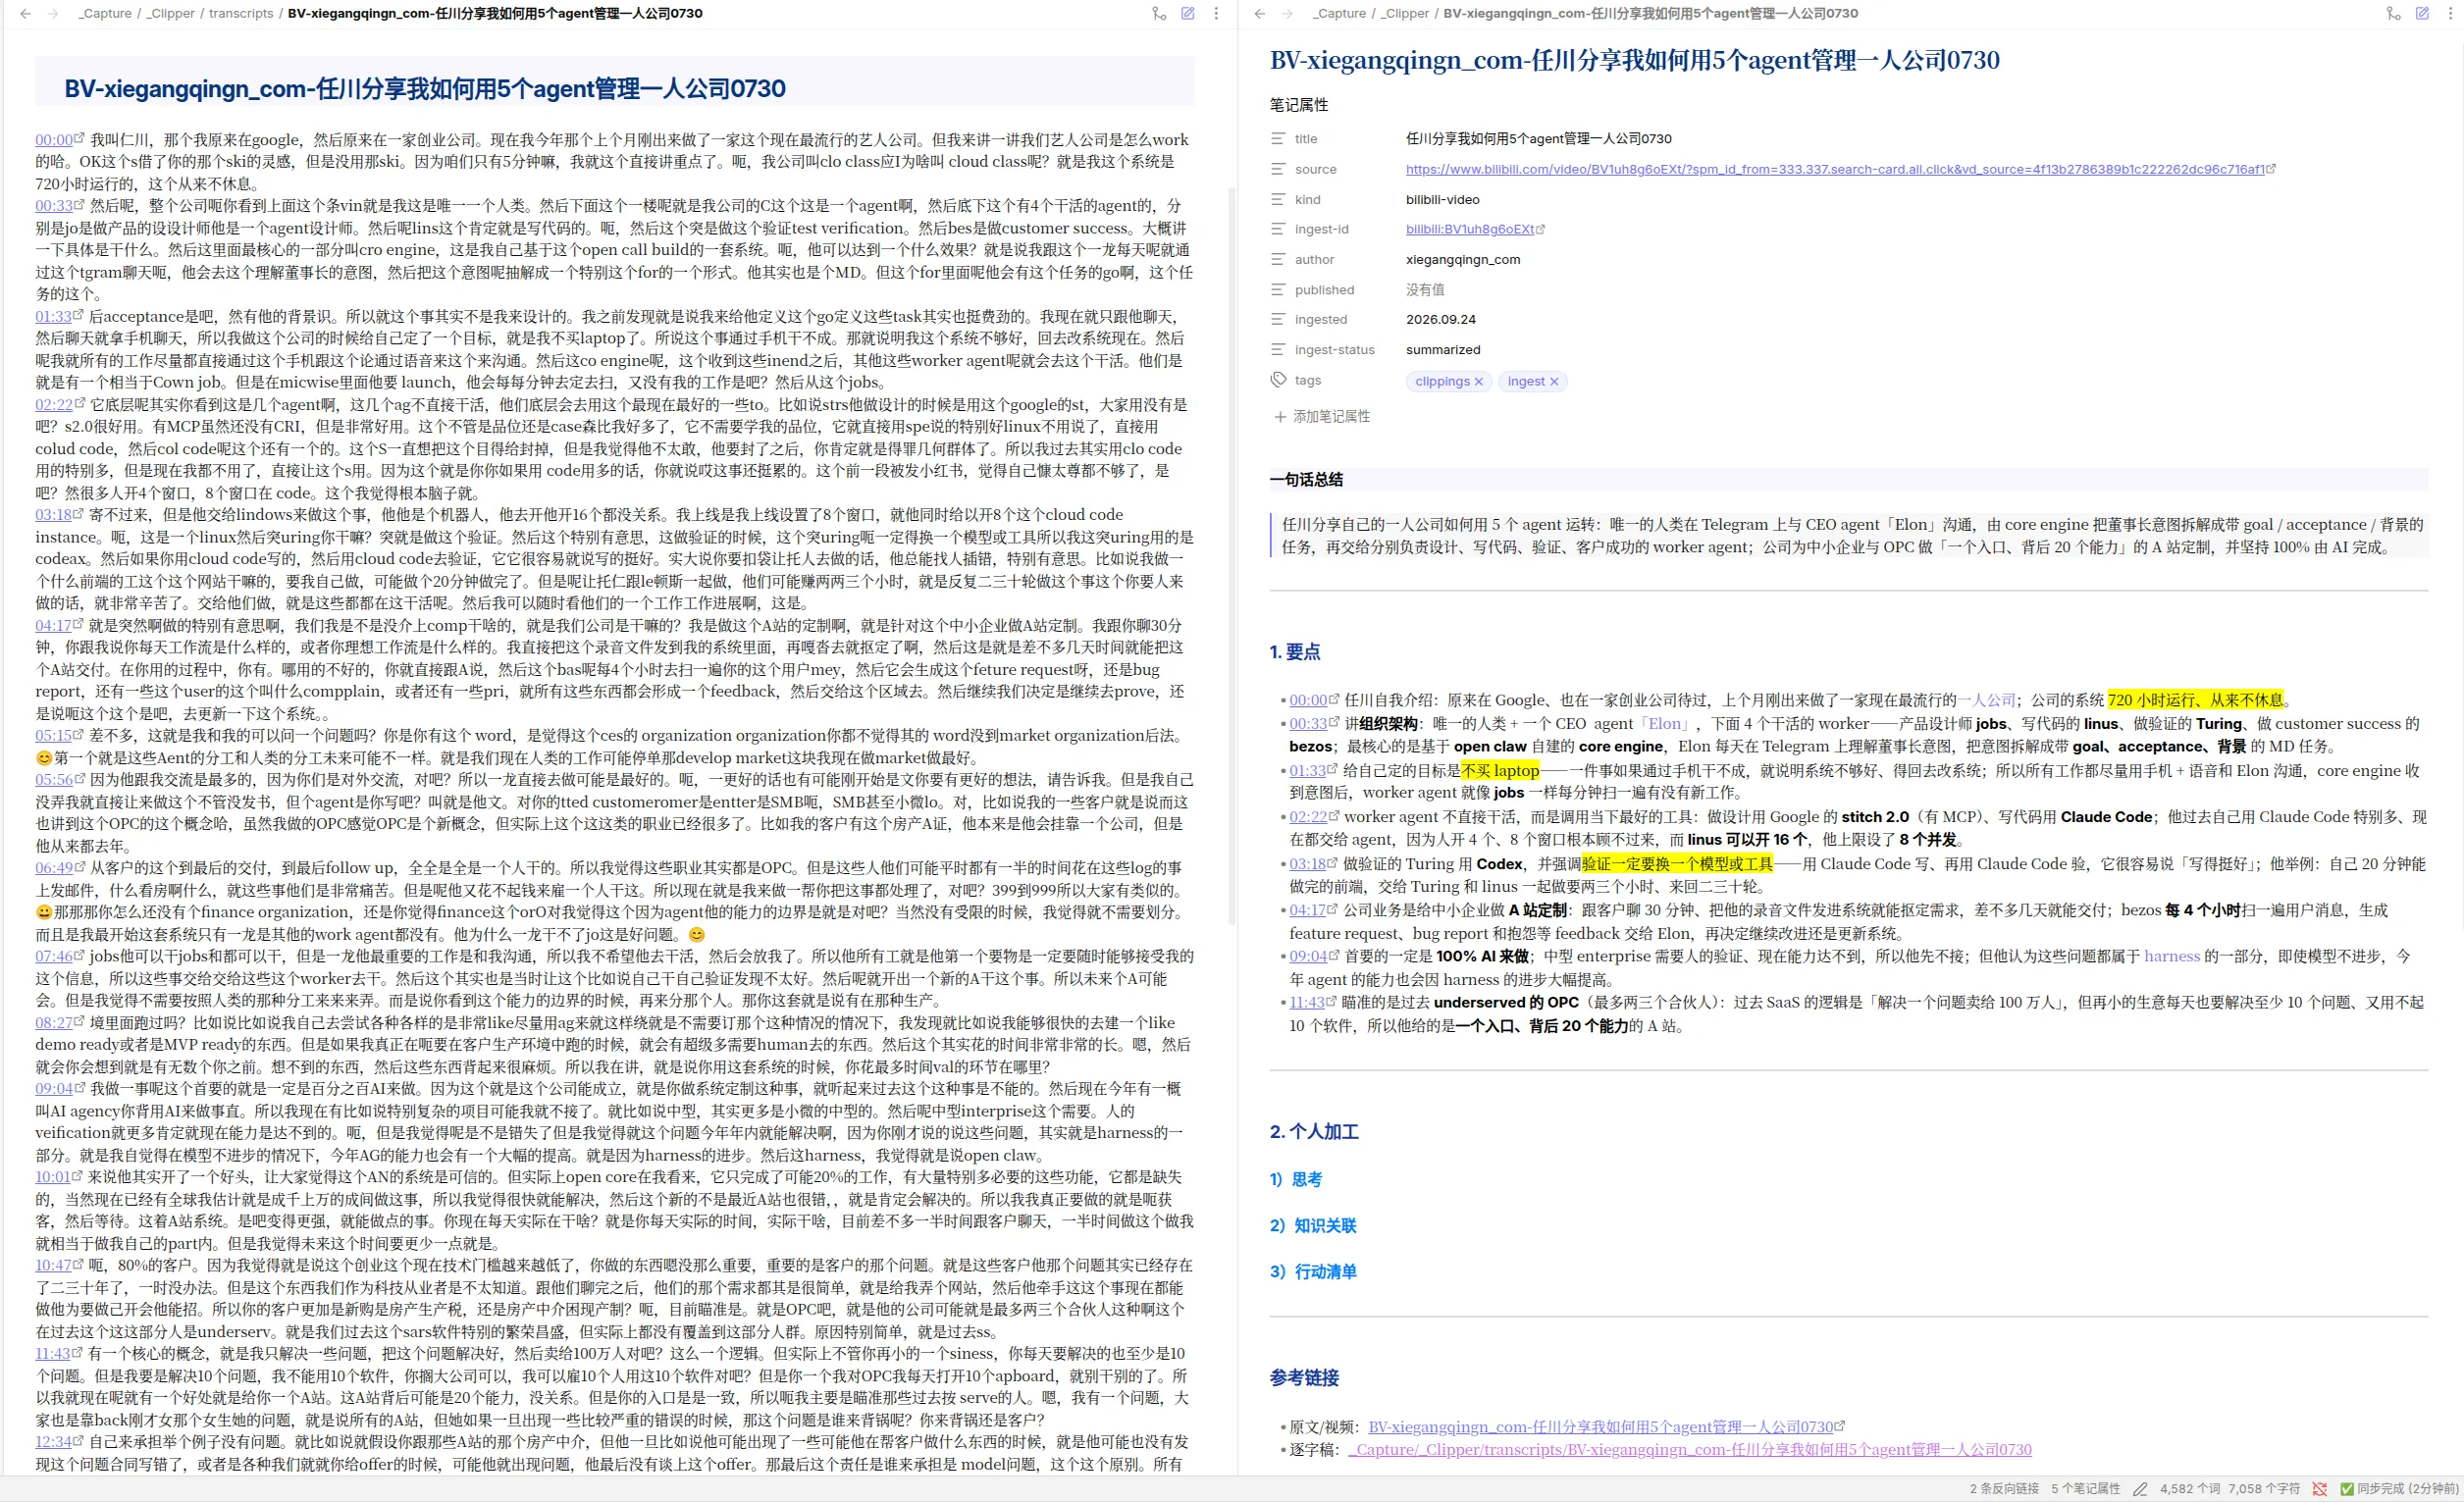
P1-BiliBili视频剪藏逐字稿(左)与AI摘要(右)
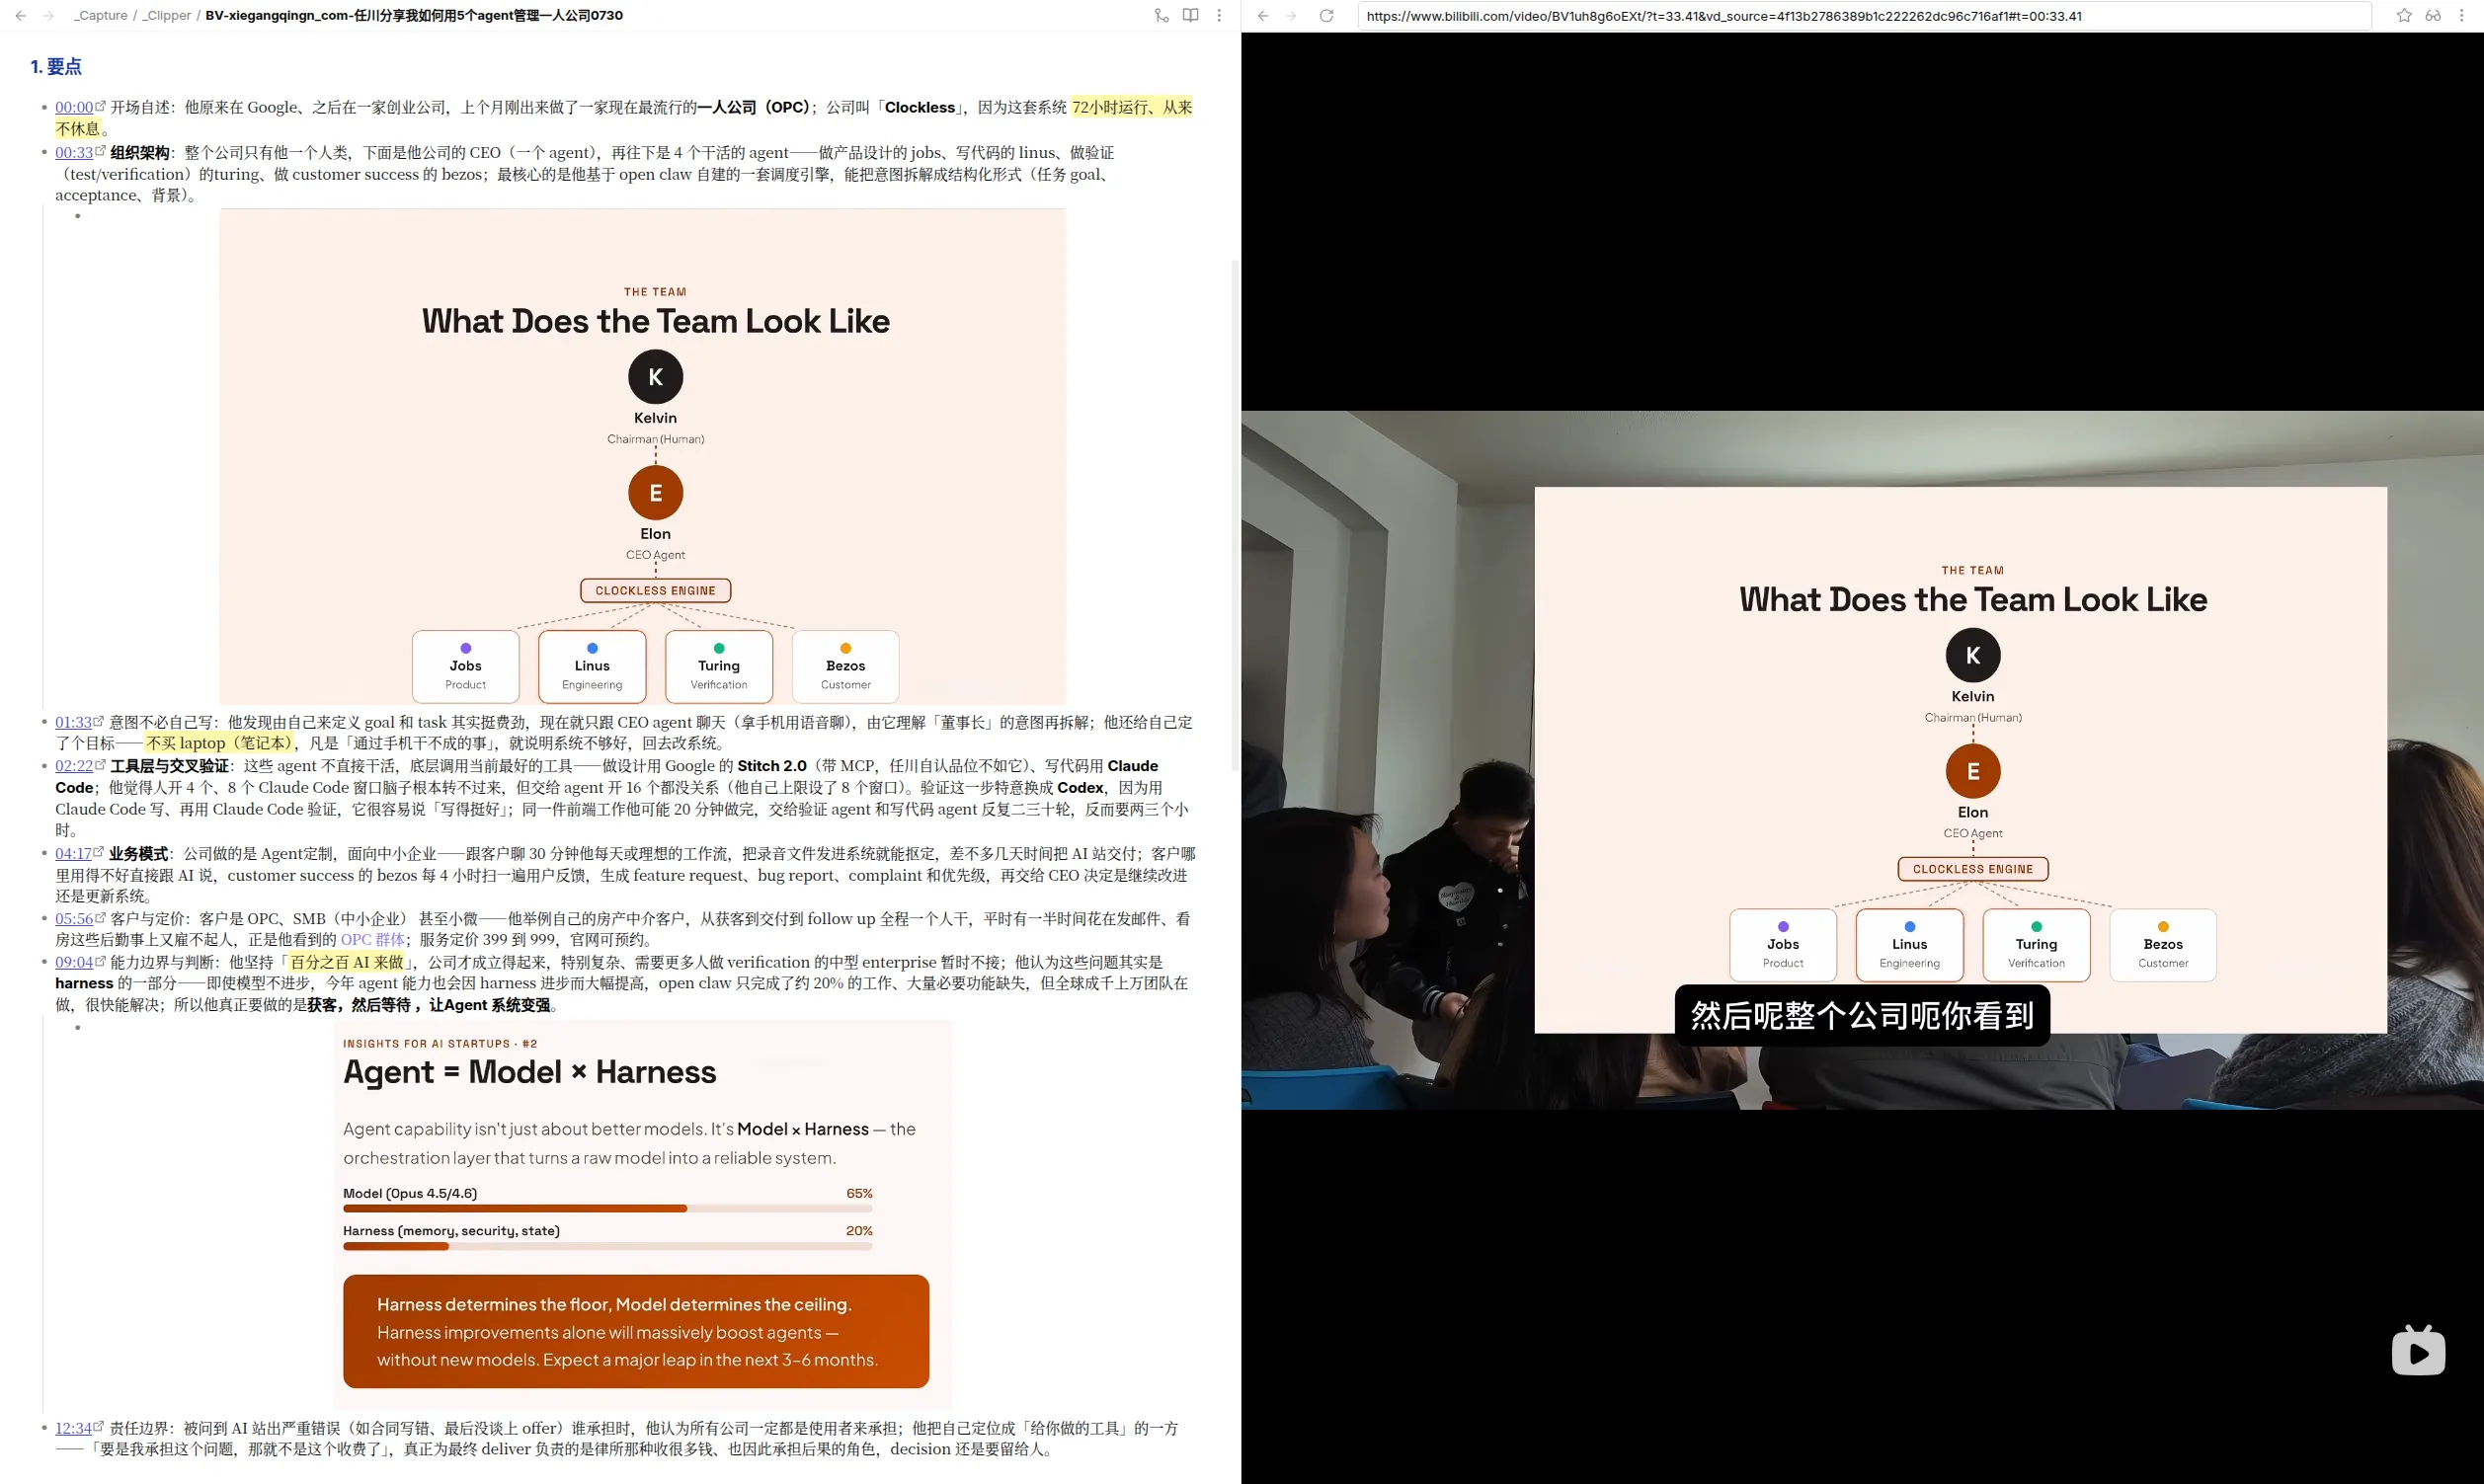
P2-点击时间戳可跳转到原视频位置(需要安装 Obsidian Media Extended 插件),结合视频对 "#要点" 进行加工
二、操作步骤
请先下载文章开头链接中的
vault-ingest.zip资源包,并将包内子文件提取到相应文件目录。
(一) 资源包构成
解压后对照本节逐项放置。单个压缩包不超过 25MB,超出时拆分分卷或将大文件移至网盘并在正文中给出链接。顶层以
vault-ingest命名,内部即目标相对路径,解压后原样复制到库根目录。
vault-ingest/
├── .opencode/
│   ├── scripts/
│   │   ├── ingest.py                  # 管道主体:扫描/分类去重/抓取/转录/落盘/校验/报告(确定性、无 LLM)
│   │   ├── ingest.sh                  # 入口包装脚本:固定走 venv 的 Python 调用 ingest.py,规避系统 Python 缺包
│   │   ├── bili-cookies.sh            # cookie 助手:从浏览器导出 B 站 cookie(Netscape 格式),抓取B站现成字幕时需要
│   │   └── requirements.txt           # 依赖清单:yt-dlp、requests、PyYAML、secretstorage
│   ├── agents/
│   │   └── vault-ingestor.md          # 摘要 agent:编排三段流程+ 逐条读逐字稿写摘要
│   ├── commands/
│   │   └── vault-ingest.md            # 触发命令:/vault-ingest 入口,声明 agent: vault-ingestor
│   └── .gitignore                     # 忽略 Python 缓存:__pycache__/、*.pyc
├── _Capture/
│   └── _Clipper/
│       └── _剪藏模板.md                # 剪藏笔记格式规范:命名规则、frontmatter 与五段式正文骨架(只读,产物骨架的权威依据)
└── gitignore-append.txt               # 需追加到库根 .gitignore 的行(_Capture/_Clipper/* + !_剪藏模板.md 例外)
(二) 前置条件
- ⚠️ 本人使用系统版本为
Ubuntu22.04,Windows系统脚本可以复用,但需要对启动方式、BiliBili登陆凭证等进行修改;
- opencode 已安装,并在 PARA 库根目录(
AGENTS.md生效的目录)操作——.opencode/scripts/...这类相对路径只在库根有效; - Python ≥ 3.11(
yt-dlp已提示弃用3.10),ffmpeg可用(音频时长探测与静音切段,ASR 接口对音频时长有限制,长音频一次转写容易超时或截断,所以要先在静音处切段); - B 站账号,且 Chrome / Firefox 已登录 bilibili.com(导出 SESSDATA cookie 后管道才能免费、快速、准确地直抓 B 站现成字幕);
- SiliconFlow 账号(可选)——仅无字幕视频的 ASR 兜底需要,有字幕的视频用不到(未测试);
- Obsidian(建议)用来查看产物与转录总结;建议通过第三方插件库下载并安装
Media Extended插件;建议把_Capture/_Clipper/transcripts/加入「忽略文件」,避免逐字稿全文污染搜索(具体操作方式为设置 -> 文件与链接 -> 忽略文件); - 无需设置环境变量、无需开启实验开关:配置全部落在
~/.cache/para-ingest/(config.json/cookies.txt/secrets.json),脚本按约定路径自行读取。
(三) 操作步骤/功能验证
验证环境配置(--check / --dry-run)与首次跑通三阶段(prepare → 摘要 → finalize)
- 放入资源包:把 9 个文件放到对应位置(
.opencode/scripts/、.opencode/agents/、.opencode/commands/、_Capture/_Clipper/),gitignore-append.txt的内容追加到库根.gitignore,包内.opencode/.gitignore直接落到同名位置。- ✅ 验证:
ls .opencode/scripts/显示ingest.py、ingest.sh、bili-cookies.sh、requirements.txt。
- ✅ 验证:
- 建 venv 并装依赖:
python3 -m venv ~/.cache/para-ingest/venv ~/.cache/para-ingest/venv/bin/pip install -r .opencode/scripts/requirements.txt- ✅ 验证:
~/.cache/para-ingest/venv/bin/python -c "import yt_dlp; print(yt_dlp.version.__version__)"输出 2026 版本号。
- ✅ 验证:
- 导出 B 站 cookie(先确认 Chrome 已登录 bilibili.com):
bash .opencode/scripts/bili-cookies.sh- ✅ 验证:
~/.cache/para-ingest/cookies.txt存在、权限 600、含SESSDATA。cookie 若过期后重跑bash .opencode/scripts/bili-cookies.sh。
- ✅ 验证:
- 配置 SiliconFlow key(仅无字幕视频兜底需要,可后补):
printf '{\n "siliconflow_api_key": "你的KEY"\n}\n' > ~/.cache/para-ingest/secrets.json chmod 600 ~/.cache/para-ingest/secrets.json- ✅ 验证:
bash .opencode/scripts/ingest.sh --check显示SILICONFLOW_API_KEY:已设置。
- ✅ 验证:
- (可选)Obsidian 排除逐字稿目录:设置 → 文件与链接 → 忽略文件 → 添加
_Capture/_Clipper/transcripts/。- ✅ 验证:该目录下的文件不再出现在 Obsidian 搜索。
- 干跑确认分类正确:
bash .opencode/scripts/ingest.sh --dry-run,只扫描 + 分类 + 判重,不联网不写文件。- ✅ 验证:输出中
bilibili-video/web-article识别正确。
- ✅ 验证:输出中
- 运行工作流:在 opencode 输入
/vault-ingest,agent 自动完成 prepare → 摘要 → finalize 三阶段。- ✅ 验证:终端依次显示「prepare 完成 / 摘要写入 / finalize 完成」,
_Capture/_Clipper/出现摘要笔记、逐字稿与_剪藏回顾.md。
- ✅ 验证:终端依次显示「prepare 完成 / 摘要写入 / finalize 完成」,
- 抽查摘要可信度:视频笔记每个带链接的时间戳要点能在逐字稿对应行找到,且点击可跳回视频;文章要点引句逐字出现在正文。
- ✅ 验证:打开
_Capture/_Clipper/_剪藏回顾.md,确认累计总览表与本批产物一致(本批条目在表头下方,重复运行不重复追加)。
- ✅ 验证:打开
(四) 常见问题
- 系统 yt-dlp 是古董版:系统自带的依据系统版本而定,B 站接口早已变更;必须用 venv 内安装的新版,
ingest.sh封装已强制走 venv,勿绕过它直接跑python ingest.py; - 重复处理与续跑:已处理的源剪藏留在
_Capture/根目录不动(源剪藏只读,用户可以删除),靠_Clipper/.ingest-ledger.json判重;笔记框架存在但ingest-status: new(即已生成逐字稿但未正确生成摘要)时重跑会「续跑」(不再抓取、不覆盖已写内容),summarized(即摘要已校验通过,且逐字稿和摘要同时存在) 会跳过执行命令; - 产物为何不进 git:
_Capture/_Clipper/下的管道产物被.gitignore忽略——产物是中间态,进 git 会造成每周提交噪音,靠坚果云等同步盘备份;唯一例外是格式规范_剪藏模板.md,它随资源包分发、需要跟着版本迭代,故.gitignore为其保留!例外行; - 摘要被判
needs-review:说明 agent 写的某个锚点(时间戳或引句)在逐字稿里找不到,脚本拒绝放行;人工核对后修正摘要再跑--finalize; - 为什么摘要由 agent 写而不是脚本调 API:opencode CLI 不在 PATH,且会话嵌套有风险,脚本刻意不 shell 调
opencode,改由 agent 直接编排最稳。
三、架构解析
(一) 文件职责
| 文件 | 职责 | 关键操作 |
|---|---|---|
.opencode/scripts/ingest.py | 确定性管道主体(全程无 LLM) | 扫描 _Capture/*.md → 分类(重命名)/去重 → 抓取转录 → 写骨架+逐字稿+manifest → finalize 校验/记账/并入剪藏回顾总览 |
.opencode/scripts/ingest.sh | venv 统一入口 | 解析 ~/.cache/para-ingest/venv 的 Python 绝对路径后 exec ingest.py |
.opencode/scripts/bili-cookies.sh | cookie 导出 | extract_cookies_from_browser + jar.save() 写 Netscape 文件;chmod 600 |
.opencode/agents/vault-ingestor.md | 摘要 agent | 跑 ingest.sh --prepare → 逐条读逐字稿写摘要 → --finalize;只改笔记「一句话总结 + 要点」两处 |
.opencode/commands/vault-ingest.md | 触发命令 | 声明 agent: vault-ingestor 与流程说明,输入 /vault-ingest 即进入 agent 流程 |
.gitignore(库根) | 忽略产物 | 追加 _Capture/_Clipper/* 与 !_Capture/_Clipper/_剪藏模板.md(规范文档例外跟踪) |
.opencode/.gitignore | 忽略 Python 缓存 | __pycache__/、*.pyc |
_Capture/_Clipper/_剪藏模板.md | AI摘要参考格式规范 | — |
关键说明:工作流把「确定性」与「推理」物理分离——ingest.py 全程无 LLM,可幂等、可单测、失败可见;vault-ingestor agent 只做「读逐字稿 → 写摘要」这一件推理事情。
(二) 调用关系
/vault-ingest(命令,声明 agent: vault-ingestor)
        │
        ▼
vault-ingestor agent(编排三段流程:① prepare → ② 写摘要 → ③ finalize)
        │
        │  ①③ 各跑一次 bash .opencode/scripts/ingest.sh
        ▼
ingest.sh(venv 入口)──exec──▶ ingest.py(确定性管道,全程无 LLM;被调用两次)
        │
        ├── 外部依赖
        │     ├── yt_dlp        B 站元数据 / 现成字幕 / 音频
        │     ├── ffmpeg        仅走 ASR 时才用:静音检测切段
        │     └── SiliconFlow   /v1/audio/transcriptions(ASR 兜底)
        │
        └── 运行时状态 ~/.cache/para-ingest/
              ├── 读 cookies.txt(B 站登录态)、secrets.json(ASR key)
              └── 写 media/<base>/(音频与切片缓存)

产物(均在 _Capture/_Clipper/,标注写入方)
        ├── <base>.md               ① 写空骨架 → ② agent 填「一句话总结 + 要点」→ ③ 回写 ingest-status
        ├── transcripts/<base>.md   ① 写(完整逐字稿;② 读它来写摘要)
        ├── .ingest-manifest.json   ① 写本批快照;② ③ 读
        ├── .ingest-ledger.json     ① ③ 更新(判重、记账)
└── _剪藏回顾.md ③ 并入(累计总览表:去重、最新在上;失败条目只终端汇报)(旁支:bili-cookies.sh → yt_dlp.cookies.extract_cookies_from_browser,产出 ~/.cache/para-ingest/cookies.txt 供 yt_dlp 与 requests 取用。)
(三) 设计意图
- 脚本不做 LLM、agent 不做抓取:抓取/转录是确定性 I/O 活,放脚本里可幂等、可测试、单条失败不拖垮整批任务;摘要是推理活,交给 agent 用 opencode 模型。脚本不 shell 调 opencode;
- 字幕优先、ASR 兜底:B 站大部分视频有 CC / AI 字幕(
ai-zh等),直抓字幕免费、快、准确率高;无字幕才下音频转写。云 ASR 选 SiliconFlowSenseVoiceSmall(免费档、OpenAI 兼容、中文效果好),❌该兜底路径尚未实测; - 锚点强制防捏造:视频摘要的时间戳锚点直接复用逐字稿里的跳转链接(点击可跳回 B 站对应位置),
--finalize再机械校验一遍(时间戳在逐字稿中真实存在、文章引句逐字可查),校验不过则标needs-review。这是「AI 总结不编造」的机制保障而非提示词愿望; _Clipper/git 忽略 + 同步备份:管道产物是中间态,进 git 会造成每周噪音;靠坚果云备份,源剪藏保持只读,_Capture/收件箱语义不破(规范文档_剪藏模板.md例外,仍纳入版本管理);
四、进阶功能
问询 OpenCode 直接帮你实现如下功能:
- 新增输入源(YouTube / 本地视频 / 图片 OCR);
- 多平台开发(Ubuntu/Windows);
- ASR 功能测试,更换 ASR 引擎;
- 调整摘要锚点规则:
vault-ingestor.md的摘要硬规则 +ingest.py的validate_note同步改(如要求视频要点同时带时间戳与引句);验证方式是写一条不合规摘要跑--finalize,应被标needs-review; - 改参考笔记骨架、模板:
build_note_file/build_transcript_file;_剪藏模板.md
参考资料
- yt-dlp 文档:管道里唯一的外部视频/字幕抓取器。
- SiliconFlow 文档:ASR 兜底所用转录接口的提供方。
